Le culte du cargo de la clean architecture
À l'issue de la Seconde Guerre mondiale, dans les îles reculées du Pacifique, des populations restées à l'écart du monde industriel virent débarquer des armées entières. Avec elles arrivèrent des avions chargés de vivres et de matériel de première nécessité : des richesses tombées du ciel comme par miracle. Mais quand la guerre s'acheva, les troupes repartirent, et le ciel se vida.
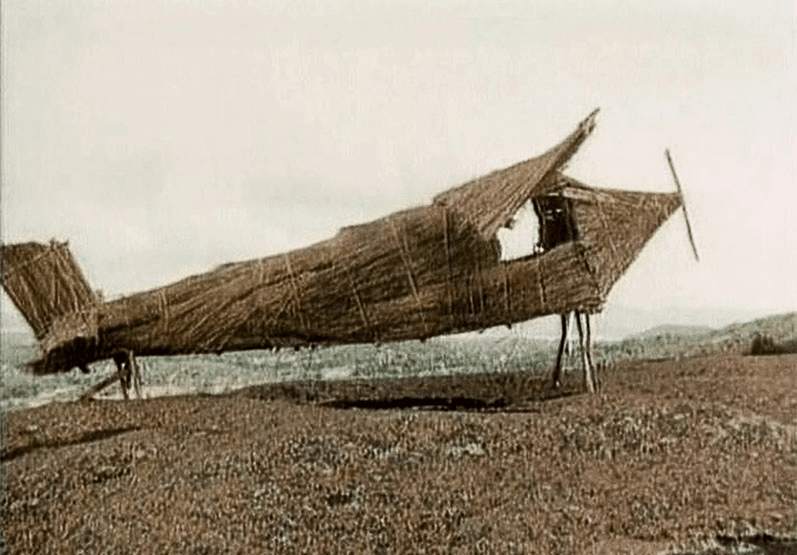
Pour faire revenir l'abondance disparue, certains entreprirent de reproduire ce qu'ils avaient vu : ils défrichèrent des pistes, les balisèrent de feux, dressèrent des tours de contrôle en bambou, jusqu'à reconstruire des répliques d'avion cargo. Puis ils s'assirent là, des moitiés de noix de coco sur les oreilles en guise de casque, des antennes de bois pointées vers les nuages. Tout y était. La forme était parfaite. Les avions ne revinrent jamais.
 plane.png
C'est le physicien Richard Feynman qui a popularisé cette image, dans un discours resté célèbre sur la "cargo cult science" (Caltech, 1974) : reproduire à la perfection l'apparence d'une chose en ayant manqué ce qui la fait fonctionner. Tous les jours, que ce soit au sein de mes missions, sur les réseaux sociaux ou sur les sites de tutoriels, on retrouve exactement le même phénomène avec la Clean Architecture : des dossiers domain, application, infrastructure respectés à la lettre, des interfaces partout, quatre couches d'abstraction pour un service et j'en passe. La forme semble correcte, pourtant l'avion n'arrive pas : le code est toujours aussi rigide, toujours complexe à tester (voire pas testé du tout), toujours aussi couplé. On paye le prix de l'abstraction sans jamais en voir le bénéfice, et on finit par accuser la Clean Architecture de tous les maux.
Note : je parle ici de Clean Architecture, mais tout ce qui suit s'applique également à l'architecture hexagonale, à l'oignon, etc. Ces différentes "architectures" (ou plutôt principes architecturaux) reposent en réalité sur strictement la même recommandation, que nous aborderons plus loin.
Ce piège n'a rien à voir avec l'intelligence. Pendant longtemps, avant de creuser la littérature disponible sur ces sujets et d'expérimenter, j'ai moi-même construit mes propres pistes en bois et mes avions de paille. Le but de cet article n'est pas de vous apprendre les dix commandements de la Clean Architecture, mais de vous expliquer POURQUOI on applique ces règles. Car une règle appliquée sans raison, ce n'est plus une règle : c'est un rituel. Et à la fin, vous repartirez avec trois questions simples pour démasquer vos propres pistes en bois.
La Clean Architecture, c'est quoi ?
Avant de parler de ce qui cloche, entendons-nous sur l'idée. Elle tient en une phrase : organiser le code pour que la logique métier ne dépende pas de la technique. Le quoi ne dépend pas du comment.
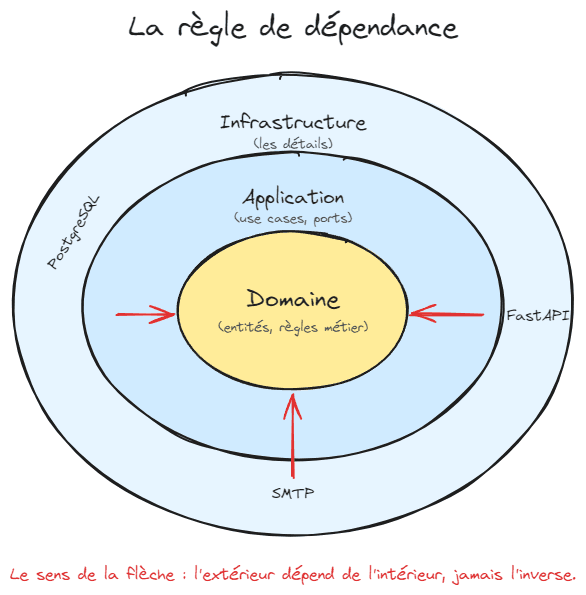
Tout part de là. Le métier (signer un contrat, valider une commande, calculer un tarif) n'a aucune raison de savoir si les données vivent dans PostgreSQL ou dans un fichier plat, si la requête arrive par HTTP ou par pigeon voyageur, si vous utilisez FastAPI ou Django. Ces choix sont des détails, au sens littéral : ils peuvent changer sans que le métier bouge. La Clean Architecture consiste à mettre le métier au centre et à repousser ces détails vers la périphérie.
Note : "détail" ne veut dire ni sans importance ni facile à changer, et surtout, la frontière n'est pas la même pour tout le monde. Ce qui est un détail pour un système est le cœur du métier d'un autre : pour un site e-commerce, la latence est un sujet d'infrastructure ; pour une plateforme de trading, c'est une exigence métier à part entière. De même, la localisation des données ou la durée de rétention relèvent de la plomberie pour la plupart des produits, mais deviennent de véritables règles métier dès que la compliance s'en mêle (RGPD, secteur bancaire, santé). Et un choix très coûteux à défaire (un modèle de persistance, un fournisseur cloud) reste un détail au sens architectural tant que le métier n'a pas besoin de le connaître, même s'il n'a rien d'anodin. La question n'est donc jamais "est-ce technique ?" mais "mes règles métier ont-elles besoin de le savoir ?". C'est votre domaine qui trace la frontière, pas une liste universelle.
De ce principe découle la seule règle qui compte : la règle de dépendance. Les dépendances pointent vers l'intérieur, vers le métier. Le centre ne connaît jamais l'extérieur ; c'est l'extérieur qui se conforme au centre. Le métier déclare ce dont il a besoin : un port, et le code technique vient s'y brancher : un adaptateur. On inverse ainsi la dépendance naturelle : ce n'est plus le métier qui dépend de la base, c'est la base qui dépend du métier.
 clean-architecture.png
Mais... Pourquoi ?
L'argument qu'on entend le plus souvent pour justifier cette règle est celui de la stabilité : le métier serait la partie stable du système, la technique la partie volatile ; il faudrait donc protéger le premier de la seconde. L'ennui, c'est que c'est faux dans la moitié des projets. Vos règles métier changent parfois à chaque sprint, bien plus vite que votre version de PostgreSQL, qui n'a pas bougé depuis trois ans.
En réalité, l'argument de la stabilité confond deux choses : la fréquence du changement et les raisons de changer.
Que les règles métier changent tous les sprints n'est pas un problème : c'est même le signe d'un produit vivant. Le problème, c'est quand un changement métier vous oblige à toucher du code technique, ou pire, quand un changement technique vous oblige à rouvrir du code métier. La règle de dépendance ne promet pas que rien ne changera : elle promet que chaque changement restera là où il est né.
Une nouvelle règle de tarification se code en langage métier, dans du code métier, sans qu'une session SQLAlchemy ou un décorateur Flask vienne s'inviter dans le diff. Ce qu'on cherche à minimiser, ce n'est pas le changement, c'est son blast radius, le rayon des dégâts d'une modification : combien de fichiers, de couches, d'équipes elle éclabousse. Pas la stabilité !
Le premier bénéfice concret : la testabilité
Si le métier ne dépend de rien de technique, alors il s'exécute sans rien de technique. Pas de base de données à provisionner, pas de docker-compose, pas de fixtures de 400 lignes avec des patchs sur la moitié des fichiers. Un comportement métier se teste en mémoire, en quelques millisecondes, de façon déterministe. Ci-dessous, un exemple (anonymisé, mais bien réel) de ce que l'on doit manipuler quand on ne respecte pas ces principes :
@patch(
    "billing.api.service.invoice.modules.taxes.volume_taxation.get_national_taxes_on_volumes_for_commodity",
    new=Mock(return_value=[]),
)
@patch(
    "billing.api.service.invoice.modules.penalty_reward.module.PenaltyRewardModule._compute_lines",
    new=Mock(return_value=[]),
)
@patch("billing.api.service.invoice.core.process.has_published_invoice", new=Mock(return_value=False))
@patch("contracts_data.model.invoice.invoice.get_vat_exoneration", new=Mock(return_value=None))
@patch("contracts_data.queries.shared.cost.get_vat_rate", new=Mock(wraps=get_vat_rate_mock))
@patch(
    "contracts_data.queries.invoice.detail_codes.get_invoice_detail_code",
    new=Mock(wraps=get_invoice_detail_code_mock),
)
# Et 10 autres...
C'est le test décisif du cargo cult, au sens propre : si vous avez les dossiers domain, application, infrastructure, les interfaces, les mappers, mais que vos tests ont toujours besoin d'une base Postgres ou d'un mur de @patch pour vérifier qu'un contrat ne peut pas être signé deux fois, alors vous avez construit la tour de contrôle en bambou. Vous payez le coût de l'abstraction (l'indirection, les fichiers en plus, le mapping) sans toucher son premier dividende.
Une précision importante, pour éviter le malentendu inverse : "tester sans infrastructure" vaut pour le métier. Vos adaptateurs, eux, doivent bien être testés contre une vraie base quelque part, des tests d'intégration, plus lents, ciblés sur le SQL et le mapping. La Clean Architecture ne supprime pas ces tests : elle les isole, pour que 95 % de votre suite tourne en mémoire et que les 5 % restants vérifient la plomberie.
C'est pour cela que le TDD est important ! Écrire vos tests en premier va naturellement vous forcer / vous guider vers une architecture découplée de ses dépendances techniques car sans cela vos tests seront douloureux à écrire (et personne n'est venu ici pour souffrir ok ?), et vous obtiendrez un design bien plus évolutif. J'y reviendrai dans un prochain article.
Le deuxième : différer les décisions, donc développer plus vite
On caricature souvent les ports en disant "personne ne remplace jamais Postgres par Mongo". C'est vrai, mais cet argument est à côté du sujet ; je dirais même que le "hotswap" d'un système de prod est l'argument le plus faible et le plus déconnecté de la Clean Architecture. L'intérêt de l'inversion de dépendance n'est pas de changer de base un jour : c'est de ne pas avoir à la choisir tout de suite, et de pouvoir remplacer une solution temporaire par la vraie le moment venu.
Une bonne architecture, disait Uncle Bob, est celle qui maximise le nombre de décisions non prises. Avec un port ContractRepository, votre équipe livre et teste de la logique métier dès le premier jour avec un adaptateur en mémoire, pendant que le choix d'infrastructure mûrit. Le port n'est pas une assurance contre un futur improbable : c'est un outil d'accélération du présent.
Soyons honnêtes sur le coût d'entrée : écrire les ports, les fakes, le câblage, c'est du travail en amont. Le gain de vitesse est réel, mais il est différé de quelques jours, c'est un emprunt, on y reviendra. Ce qu'on achète avec, en revanche, vaut cher : la base de données, le modèle de persistance, tout cela est complexe à faire évoluer une fois en place. Et le design peut vous surprendre : après quelques retours utilisateurs, vous découvrirez que vous avez besoin de beaucoup plus simple, ou de beaucoup plus complexe et ce changement s'opérera à moindre coût.
Le constat vaut double dans les grosses entreprises, où notre travail dépend très souvent de celui d'autres équipes. La capacité à livrer malgré une dépendance manquante et à avoir rapidement des feedbacks utilisateurs fait la différence entre un projet qui montre des résultats et un projet qui se fait geler, voire démanteler, faute d'en montrer.
Le troisième : un code qui se lit dans la langue du problème
Attribuons ce bénéfice correctement. La lisibilité vient d'abord d'un modèle riche, qui parle la langue du métier : on peut l'obtenir sans le moindre port. Ce que la règle de dépendance apporte, c'est la garantie que cette langue ne sera pas polluée : quand les dépendances pointent vers l'intérieur, rien de technique ne peut s'inviter dans le centre, et le cœur de votre application raconte ce que fait le système, dans les mots du métier et ce, durablement.
Ouvrir un use case et y lire contract.authorize_perimeters_addition(perimeters_batch) ou encore contract.sign(date_of_signature) plutôt qu'un enchaînement de session.query().filter().join(), ce n'est pas de l'esthétique : c'est de la charge cognitive en moins pour chaque développeur qui devra raisonner sur ce code.
L'argument prend encore plus de poids à l'heure du développement agentique. L'IA écrit vite, mais la relecture, elle, reste le goulot d'étranglement : un code qui s'exprime en langage quasi naturel, adossé à des tests qui garantissent le comportement, est un code qu'on relit vite. Quant à ceux qui relisent de moins en moins le code lui-même pour s'attarder sur le processus (comment l'agent raisonne, quelle conception du métier il se construit), c'est encore plus décisif : un agent qui vous parle en langage métier révèle immédiatement s'il a compris les enjeux ou non.
La Clean Archi, concrètement
Rendons tout cela tangible. Au centre, le domaine — ici un contrat — avec une règle de gestion qu'il protège lui-même : une fois signé, il est figé.
# domain/contract.py
from dataclasses import dataclass
from datetime import date
from enum import Enum
from uuid import UUID


class Status(Enum):
    DRAFT = "draft"
    SIGNED = "signed"


class ContractAlreadySigned(Exception):
    """A signed contract is frozen: it cannot be re-signed or amended."""


class CannotMixCurrencies(Exception): ...


@dataclass(frozen=True)
class Money:
    cents: int
    currency: str

    def __add__(self, other: "Money") -> "Money":
        if self.currency != other.currency:
            raise CannotMixCurrencies(self.currency, other.currency)
        return Money(self.cents + other.cents, self.currency)


@dataclass
class Contract:
    id: UUID
    amount: Money
    status: Status = Status.DRAFT
    signed_on: date | None = None

    def sign(self, on: date) -> None:
        if self.status is Status.SIGNED:
            raise ContractAlreadySigned(self.id)
        self.status = Status.SIGNED
        self.signed_on = on

    def amend_amount(self, amount: Money) -> None:
        if self.status is Status.SIGNED:
            raise ContractAlreadySigned(self.id)
        self.amount = amount
Le métier déclare son besoin via un port, qu'il possède :
# application/ports.py
from abc import ABC, abstractmethod
from uuid import UUID

from domain.contract import Contract


class ContractRepository(ABC):
    @abstractmethod
    def by_id(self, contract_id: UUID) -> Contract | None: ...

    @abstractmethod
    def save(self, contract: Contract) -> None: ...
Le cas d'usage orchestre et ne dépend que du port. Remarquez qu'il est mince : la décision "déjà signé" n'est pas ici, elle est dans l'entité.
# application/sign_contract.py
from datetime import date
from uuid import UUID

from application.ports import ContractRepository


class ContractNotFound(Exception): ...


class SignContract:
    def __init__(self, contracts: ContractRepository) -> None:
        self._contracts = contracts

    def execute(self, contract_id: UUID, on: date) -> None: # We could inject a clock here as well
        contract = self._contracts.by_id(contract_id)
        if contract is None:
            raise ContractNotFound(contract_id)
        contract.sign(on)  # the "already signed" rule lives in the domain
        self._contracts.save(contract)
L'adaptateur, en infrastructure, implémente le port : c'est ici, et seulement ici, que vit le SQL.

# infrastructure/sql_contract_repository.py
from uuid import UUID

from sqlalchemy.orm import Session

from application.ports import ContractRepository
from domain.contract import Contract


class SqlContractRepository(ContractRepository):
    def __init__(self, session: Session) -> None:
        self._session = session

    def by_id(self, contract_id: UUID) -> Contract | None:
        ...  # SQL/ORM + mapping to/from the persistence model

    def save(self, contract: Contract) -> None:
        ...
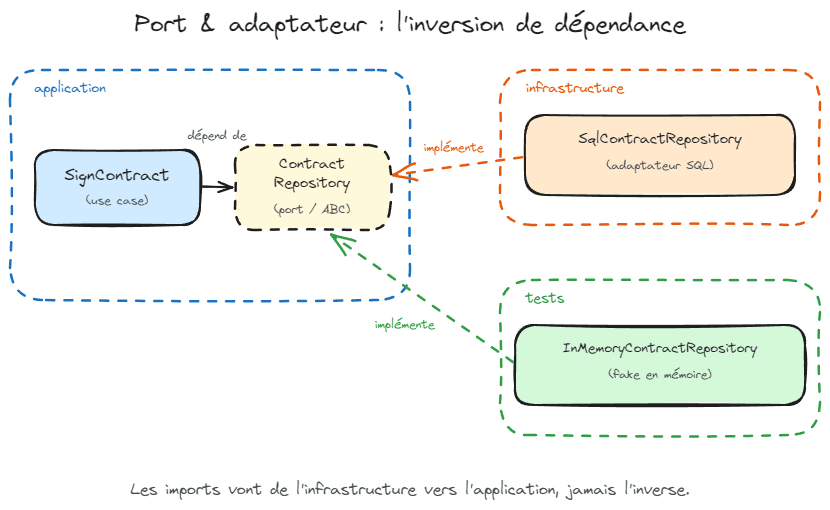
L'inversion se lit dans les import eux-mêmes : infrastructure importe domain et application ; jamais l'inverse. Le branchement se fait au bord du système, là où l'on injecte le concret dans l'abstrait :
# at the edge (main, FastAPI wiring…)
repo = SqlContractRepository(session)
use_case = SignContract(contracts=repo)
Et le "tester sans infrastructure" devient littéral : un faux dépôt en mémoire suffit.
# tests/fakes.py
from uuid import UUID

from application.ports import ContractRepository
from domain.contract import Contract


class InMemoryContractRepository(ContractRepository):
    def __init__(self) -> None:
        self._data: dict[UUID, Contract] = {}

    def by_id(self, contract_id: UUID) -> Contract | None:
        return self._data.get(contract_id)

    def save(self, contract: Contract) -> None:
        self._data[contract.id] = contract
Voici enfin le dividende promis : le test qui justifie toute la machinerie qui précède :
# tests/test_sign_contract.py
from datetime import date
from uuid import uuid4

import pytest

from application.sign_contract import SignContract
from domain.contract import Contract, ContractAlreadySigned, Money
from tests.fakes import InMemoryContractRepository


def test_a_signed_contract_cannot_be_signed_twice():
    contract_id = uuid4()
    repo = InMemoryContractRepository()
    repo.save(Contract(id=contract_id, amount=Money(10_000, "EUR")))
    use_case = SignContract(contracts=repo)

    use_case.execute(contract_id, on=date(2026, 1, 15))

    with pytest.raises(ContractAlreadySigned):
        use_case.execute(contract_id, on=date(2026, 2, 1))
Zéro @patch. Zéro docker-compose. Zéro fixture de 400 lignes. Le test se lit comme la règle qu'il vérifie, s'exécute en quelques millisecondes, et donnera le même résultat dans dix ans. Comparez-le au mur de décorateurs du début de l'article : c'est exactement le même genre de règle métier qui est testé, la différence, c'est l'architecture.
 dependancy-inversion.png
Si vous avez l'impression d'avoir déjà lu tout cela sous d'autres noms, c'est normal. L'architecture hexagonale ("ports et adaptateurs", Cockburn), l'oignon (Palermo) et la Clean Architecture (Martin) racontent la même histoire : un métier au centre, des détails à la périphérie, une dépendance qui pointe vers l'intérieur. Le dessin change (hexagones, cercles, couches, etc.), l'idée est identique. Inutile de chercher laquelle est "la bonne" : ce sont trois représentations du même principe. Reste à savoir ce qu'on en fait et c'est là que le culte commence.
Les pistes en bois
Maintenant qu'on tient les raisons, les pistes en bois deviennent faciles à repérer. En voici quatre, parmi les plus répandues. À chaque fois, le même schéma : la forme est parfaite, et la cause a disparu en route.
1. Le dossier n'est pas l'architecture
La plus courante : croire que l'architecture, ce sont les dossiers. On crée domain/, application/, infrastructure/, on y range les fichiers, et on se déclare clean. Mais l'arborescence ne dit rien du sens de la flèche. On tombe très souvent sur ceci, dans un fichier pourtant rangé sous domain/ :
# domain/contract.py — right folder, wrong direction
from sqlalchemy.orm import Session

class Contract:
    def sign(self, session: Session, on: date) -> None:
        if self.status is Status.SIGNED:
            raise ContractAlreadySigned(self.id)
        self.status = Status.SIGNED
        session.execute(...)  # the core reaches straight into infrastructure
Le dossier dit "domaine", l'import dit "base de données". La flèche pointe vers l'extérieur : changer d'ORM oblige à rouvrir le cœur, et le moindre test exige une vraie base. Les trois dossiers sont impeccables, et la règle de dépendance est morte. L'avion, c'est la direction de la dépendance, pas le rangement. Le domaine n'a jamais entendu parler de Session ni de SQL ; l'I/O ressort vers l'adaptateur. On peut respecter la règle sans aucun dossier nommé domain, et créer les trois dossiers en la violant dans chacun. Le tracé sur le disque est une conséquence de l'architecture, jamais sa preuve.
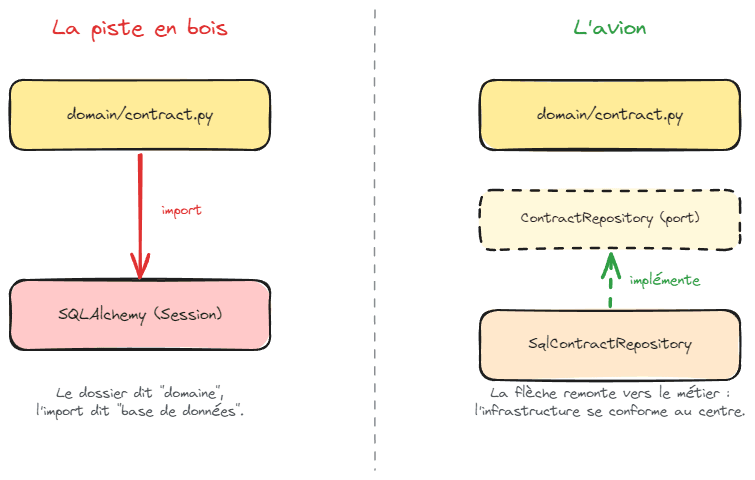 dependancy-inversion-example.png
2. Tout abstraire par réflexe
La deuxième piste en bois n'a pas de forme fixe mais s'apparente plutôt à un réflexe : abstraire par défaut. Une interface devant chaque service, une factory devant chaque constructeur, une couche de mappers entre chaque étage, un Generic[T] "au cas où". Le réflexe se déguise en prudence : "comme ça, ce sera découplé, réutilisable, testable".
Le piège, c'est qu'aucune de ces abstractions n'est mauvaise en soi. Une interface vers un autre bounded context est saine, elle vous protège du modèle du voisin et vous la doublez en test. Un Value Object qui défend un vrai invariant gagne sa place : c'est le Money que vous avez croisé plus haut, qui rend l'addition d'euros et de dollars impossible par construction. Le culte ne consiste donc pas à abstraire ; il consiste à abstraire sans avoir répondu à une seule question : qu'est-ce que ça m'achète, ici ?
Regardez ce qui arrive quand on ne pose jamais cette question. Voici, à peine caricaturé, un envoi de notification tel qu'on le croise dans des codebases "clean" :
# ceremony: four types across four files... to call one constructor

# application/ports/notification.py
class NotificationSender(ABC):
    @abstractmethod
    def send(self, recipient: str, message: str) -> None: ...


# application/ports/notification_factory.py
class NotificationSenderFactory(ABC):
    @abstractmethod
    def create(self) -> NotificationSender: ...


# infrastructure/smtp_sender.py
class SmtpNotificationSender(NotificationSender):
    def send(self, recipient: str, message: str) -> None:
        ...  # actual SMTP call


# infrastructure/smtp_sender_factory.py
class SmtpNotificationSenderFactory(NotificationSenderFactory):
    def create(self) -> NotificationSender:
        return SmtpNotificationSender()


# wiring
sender = SmtpNotificationSenderFactory().create()
Posons la question à chaque étage :
- Le port
NotificationSender: qu'est-ce qu'il m'achète ? Une couture d'I/O : c'est lui que je remplace par un fake en test, lui qui tient le SMTP hors de mon métier. Emprunt justifié. - La factory, maintenant : qu'est-ce qu'elle m'achète ? Sa méthode
createtient en une ligne, ne prend aucun argument, ne fait aucun choix, n'encapsule aucune construction complexe. Elle n'a qu'une seule implémentation, appelée une seule fois, au démarrage. Elle n'existe que parce que "le pattern existe" et elle coûte deux types, deux fichiers et une indirection de plus à chaque lecture. Supprimez-la :sender = SmtpNotificationSender()au point de câblage, et vous n'avez rien perdu.
# justified: the port is a real I/O seam, you fake it in tests
class NotificationSender(ABC):
    @abstractmethod
    def send(self, recipient: str, message: str) -> None: ...


# at the edge, plain instantiation is all the "factory" you need
sender = SmtpNotificationSender()
Le signe distinctif de ce réflexe : une factory abstraite dont l'unique implémentation appelle un constructeur sans prendre la moindre décision. Une factory se justifie quand la construction décide de quelque chose à l'exécution : choisir le canal selon le tenant, assembler un objet dont la recette varie avec la configuration. Sinon, le constructeur du langage fait déjà le travail, gratuitement.
Parce que toute abstraction est un emprunt avec intérêts. Vous payez une indirection de plus à lire, à suivre, à maintenir, chaque jour, par toute l'équipe. Vous ne contractez l'emprunt que si le bénéfice est réel : une couture d'I/O ou de système externe que vous substituez en test, une variation qui existe vraiment, une frontière entre contextes. Une interface devant un collaborateur interne à implémentation unique, qu'on ne double jamais et qu'on ne remplacera pas ? Vous payez les intérêts sans rien toucher en retour. Une factory dont le create tient en une ligne et ne choisit rien ? Pareil.
Le test tient en une question, posée à voix haute devant chaque abstraction : enlevez-la, que perdez-vous concrètement ? Si la réponse est "rien, à part la symétrie", c'est une piste en bois.
3. Le domaine anémique déguisé
À l'autre extrême, et c'est l'envers exact du précédent, l'entité devient un sac de données, et toute la logique se réfugie dans des services "métier". On croit faire de la modélisation du domaine ; on fait du transaction script qui s'ignore (Transaction Script).
# domain/contract.py — anemic: nothing but data
@dataclass
class Contract:
    id: UUID
    amount: Money
    status: Status = Status.DRAFT


# application/contract_service.py — the rule lives here, and anyone can bypass it
class ContractService:
    def sign(self, contract: Contract, on: date) -> None:
        if contract.status is Status.SIGNED:
            raise ContractAlreadySigned(contract.id)
        contract.status = Status.SIGNED  # direct mutation, outside any guard
Rien n'empêche un autre coin du code de faire contract.status = Status.SIGNED sans passer par la règle. L'invariant "un contrat signé est figé" n'est protégé par personne. L'avion : la règle appartient à l'entité, là où elle est imprenable : c'est le Contract.sign du début. La décision ne peut plus être court-circuitée, parce qu'il faut passer par la méthode pour changer l'état. Et le contre-piège, parce que les deux pistes en bois se font face : si une opération n'a aucune règle (créer un brouillon vide, lire une fiche), un modèle riche serait de la décoration. Là, le transaction script est la réponse honnête. Un domaine riche n'est pas une obligation ; l'inflation de domaine est un cargo cult comme un autre, juste l'opposé du premier.
4. Mocker les ports
La dernière piste en bois est la plus sournoise, parce qu'elle survit à toutes les autres corrections. L'architecture est bonne, les flèches pointent dans le bon sens, les ports existent et l'on écrit ceci :
def test_sign_contract():
    repo = Mock(spec=ContractRepository)
    repo.by_id.return_value = Contract(id=contract_id, amount=Money(10_000, "EUR"))
    use_case = SignContract(contracts=repo)

    use_case.execute(contract_id, on=date(2026, 1, 15))

    repo.by_id.assert_called_once_with(contract_id)   # verifying the plumbing...
    repo.save.assert_called_once()                    # ...not the behavior
On a remplacé les mocks de base de données par des mocks de ports. Même maladie, nouvelle forme. Ce test ne vérifie pas que le contrat est signé : il vérifie que le use case a appelé les bonnes méthodes dans le bon ordre. Il est couplé à l'implémentation, pas au comportement. Réorganisez le use case sans changer ce qu'il fait, remplacez by_id + save par une autre découpe et le test casse alors que le système est toujours correct. C'est exactement le symptôme qu'on cherchait à fuir : un changement qui éclabousse là où il n'est pas né.
L'avion, c'est le fake : une implémentation complète du port, en version simplifiée (notre InMemoryContractRepository). Le test dialogue alors avec le système par son comportement observable : "après signature, re-signer lève une erreur". Peu importe combien de fois save a été appelé. Les mocks gardent un usage légitime : vérifier qu'une interaction est le comportement attendu, comme l'envoi d'un e-mail (je vous renvoie vers ce super article : jmock.org/oopsla2004.pdf). Mais pour un dépôt, dont le rôle est de retenir un état, le fake est presque toujours la bonne réponse.
Faire atterrir les avions
Le point commun de ces pistes en bois, c'est qu'elles copient une forme : un dossier, une abstraction, un objet, un test tout en ayant oublié la force qui la justifiait. Le dossier sans la flèche, l'abstraction sans la couture, l'objet sans sa règle, le test sans le comportement. Comme les casques en noix de coco : tous les attributs de la chose, rien de son mécanisme. La Clean Architecture n'est ni un plan de dossiers ni un quota d'interfaces. C'est une suite d'arbitrages conscients face à des forces réelles : qu'est-ce qui va changer, qu'est-ce qui va durer, qu'est-ce que je substituerai vraiment, où vivent les vraies règles. La discipline, ce n'est pas d'appliquer les règles mais de connaître la raison de chacune, et d'accepter de ne pas l'appliquer quand la raison est absente. Trois questions suffisent à démasquer une piste en bois. Posez-les régulièrement, devant votre propre code :
1. Cette abstraction, quelle force la justifie ici ? Un point d'I/O que vous substituez en test ? Une frontière avec le contexte voisin ? Une variation avérée ? 2. Mes tests métier tournent-ils sans infrastructure ? Pas de base, pas de docker-compose, pas de mur de @patch et pas non plus de mocks de ports qui vérifient la plomberie. 3. Où cette règle est-elle imprenable ? Si un invariant peut être contourné par une simple affectation, il n'est protégé par personne, quel que soit le nom du dossier.
Et pour la règle de dépendance elle-même, une bonne nouvelle : elle n'a pas besoin d'être surveillée à l'œil nu, elle se vérifie mécaniquement. En Python, import-linter (nouvelle fenêtre) import-linter permet de déclarer "domain n'importe jamais application ni infrastructure" et de casser la CI dès que la flèche s'inverse. Le dossier ne prouve rien alors que la contrainte d'import, si. C'est la différence entre une tour de contrôle en bambou et un vrai instrument. Les avions ne se posent pas parce qu'on a construit la piste. Ils se posent parce qu'on a compris pourquoi il fallait une piste.